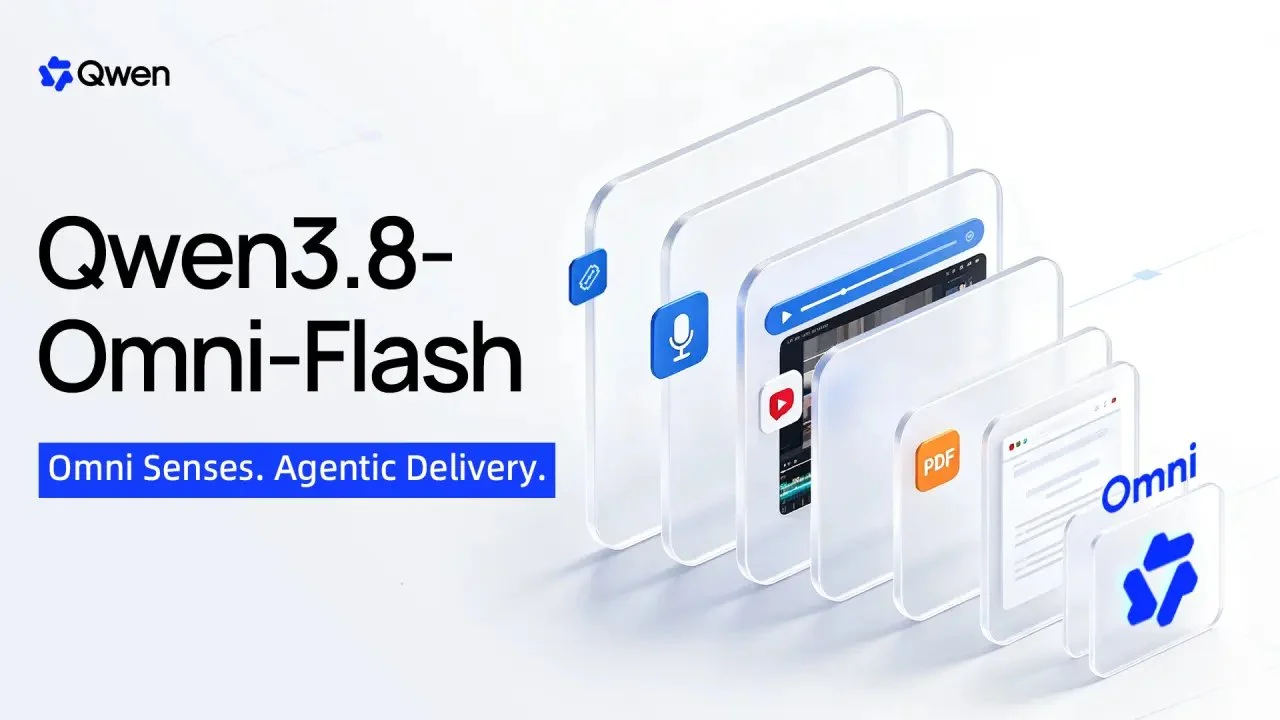
أطلقت Alibaba Cloud نموذج Qwen3.8 Omni Flash كأحدث إضافة متعددة الوسائط في عائلة Qwen، مع دعم النصوص والصور والصوت والفيديو ضمن نموذج واحد، وسياق يصل إلى مليون Token. ويستهدف الإصدار تحليل المحتوى الصوتي والمرئي، تلخيص الاجتماعات، إنشاء النصوص والترجمات النصية، إلى جانب مهام تحتاج إلى التفكير واستدعاء الأدوات والبحث على الويب.
الإجابة السريعة
Qwen3.8 Omni Flash هو نموذج متعدد الوسائط من Alibaba Cloud يستقبل النص والصورة والصوت والفيديو ويُخرج نصًا، ويدعم سياقًا بطول مليون Token، و113 لغة ولهجة في الإدخال الصوتي، والصوت متعدد القنوات، وFunction Calling والبحث على الويب. كما تضع Alibaba النموذج مباشرة كخيار بديل لـGemini 3.8 Flash في مهام فهم الصوت والفيديو، مع أسعار API أقل بوضوح على مستوى تكلفة المليون Token.
ما هو Qwen3.8 Omni Flash؟
وفق الوثائق الرسمية من Alibaba Cloud، صُمم Qwen3.8 Omni Flash لفهم وتحليل الوسائط المختلفة داخل طلب واحد. يستطيع النموذج استقبال النصوص والصور والمقاطع الصوتية والفيديو، لكنه يعيد النتيجة في صورة نصية، ما يجعله مناسبًا للمهام التي تحتاج إلى فهم المحتوى أكثر من توليد صوت جديد.
ومن الاستخدامات التي تذكرها Alibaba رسميًا: تحليل الصوت والفيديو، تلخيص الاجتماعات، استخراج المعلومات من التسجيلات، إنشاء الترجمات النصية، والإجابة عن الأسئلة المرتبطة بمحتوى مرئي أو صوتي. كما أن النموذج يدعم التفكير افتراضيًا بدرجات قابلة للتعديل، ويمكنه استدعاء وظائف خارجية واستخدام البحث على الويب.
سياق يصل إلى مليون Token
واحدة من أبرز مواصفات Qwen3.8 Omni Flash هي نافذة السياق التي تصل إلى مليون Token. الحد الأقصى للإدخال في الوضع غير المعتمد على التفكير يبلغ 991,808 Token، بينما يصل في وضع التفكير إلى 983,616 Token، مع حد أقصى للإخراج يبلغ 131,072 Token.
هذه السعة مهمة خصوصًا عند التعامل مع اجتماعات طويلة أو فيديوهات كبيرة أو ملفات متعددة، لأن النموذج يستطيع الاحتفاظ بقدر أكبر من المعلومات داخل السياق نفسه بدل تقسيم المهمة إلى عدد كبير من الطلبات المنفصلة.
| الخاصية | Qwen3.8 Omni Flash |
|---|---|
| أنواع الإدخال | نص، صور، صوت، فيديو |
| نوع الإخراج | نص |
| نافذة السياق | مليون Token |
| أقصى إخراج | 131,072 Token |
| Function Calling | مدعوم |
| البحث على الويب | مدعوم |
| التفكير | مفعّل افتراضيًا وقابل للضبط |
113 لغة ولهجة في الإدخال الصوتي مع Qwen3.8 Omni Flash
تؤكد وثائق Alibaba أن Qwen3.8 Omni Flash يدعم 113 لغة ولهجة في الإدخال الصوتي، وهو نفس نطاق دعم الإدخال في Qwen3.5-Omni. هذا يجعل النموذج مناسبًا للنسخ الصوتي، تلخيص الاجتماعات متعددة اللغات، وتحليل المحتوى الصوتي الذي لا يقتصر على الإنجليزية أو الصينية.
كما يدعم النموذج الصوت متعدد القنوات. ويمكن للمطور تفعيل تحليل استريو بقناتين أو صوت مكاني بأربع قنوات من نوع FOA، بحيث يحتفظ النموذج بالمعلومات المكانية بدل دمج كل شيء في قناة أحادية. هذه الإمكانية مفيدة في الاجتماعات والتسجيلات التي تحتوي على أكثر من متحدث أو مصدر صوتي.
مقارنة الأسعار مع Gemini 3.8 Flash
الجزء الأكثر لفتًا للانتباه في الإطلاق هو التسعير. تعرض Alibaba سعرًا دوليًا قدره 0.15 دولار لكل مليون Token إدخال و0.47 دولار لكل مليون Token إخراج لـQwen3.8 Omni Flash. وفي عدة مناطق أخرى، منها ألمانيا والولايات المتحدة واليابان وهونغ كونغ، تعرض الشركة سعر إدخال قدره 0.113 دولار وسعر إخراج 0.382 دولار لكل مليون Token.
في المقابل، تعرض Google سعرًا تمهيديًا لـGemini 3.8 Flash يبلغ 0.75 دولار لكل مليون Token إدخال و3.75 دولار لكل مليون Token إخراج حتى 31 ديسمبر 2026، على أن ترتفع الأسعار القياسية إلى 1.50 دولار للإدخال و7.50 دولار للإخراج بداية من يناير 2027.
| النموذج | سعر الإدخال لكل مليون Token | سعر الإخراج لكل مليون Token |
|---|---|---|
| Qwen3.8 Omni Flash – دولي | 0.15 دولار | 0.47 دولار |
| Qwen3.8 Omni Flash – بعض المناطق العالمية | 0.113 دولار | 0.382 دولار |
| Gemini 3.8 Flash – حتى نهاية 2026 | 0.75 دولار | 3.75 دولار |
| Gemini 3.8 Flash – من يناير 2027 | 1.50 دولار | 7.50 دولار |
وبحساب سعر المليون Token فقط، يكون سعر الإدخال الدولي لدى Alibaba أقل بنحو 80% من السعر التمهيدي الحالي لـGemini 3.8 Flash، بينما يقل سعر الإخراج بنحو 87.5%. لكن يجب الانتباه إلى أن تكلفة مهمة صوتية كاملة لا تُقاس بالسعر المجرد وحده؛ طريقة تحويل مدة الصوت إلى Tokens والاستهلاك الفعلي لكل نموذج يمكن أن تغير التكلفة النهائية.
هل خفضت Alibaba تكلفة الصوت 98% فعلًا؟
تحدثت تقارير صحفية عن انخفاض تكلفة إدخال الصوت بنسبة تصل إلى 98%، لكن الصفحات الرسمية التي راجعتها من Alibaba تعرض حاليًا أسعار Token وقدرات النموذج، ولا تقدم في الصفحة نفسها مقارنة رسمية مباشرة بهذه النسبة مع Gemini 3.8 Flash. لذلك الأدق هو الاعتماد على الأرقام الرسمية المنشورة بدل تحويل الادعاء إلى حقيقة مطلقة.
المؤكد رسميًا أن Alibaba تقدم Qwen3.8 Omni Flash بتسعير أقل من Gemini 3.8 Flash عند المقارنة المباشرة لسعر المليون Token، وأن صفحة النماذج متعددة الوسائط لدى Alibaba نفسها تضع Gemini 3.8 Flash كمثال لنموذج مغلق يمكن الانتقال منه إلى qwen3.8-omni-flash في مهام فهم الصوت والفيديو.
منافس مباشر لـGemini في فهم الصوت والفيديو
لا تخفي Alibaba المقارنة. ففي صفحة النماذج متعددة الوسائط الرسمية، توصي الشركة بـQwen3.8 Omni Flash لمن يريد الانتقال من Gemini 3.8 Flash في مهام فهم الصوت والفيديو وإنتاج النصوص. هذا لا يعني أن Alibaba أثبتت تفوقه في كل اختبار، لكنه يوضح بوضوح السوق الذي تستهدفه.
الفرق المهم أن الإصدار الجديد ليس نموذج محادثة صوتية لحظية. فإذا كان المطلوب إخراجًا صوتيًا أو محادثة Real-time، توصي Alibaba باستخدام نماذج Qwen3.5-Omni المناسبة لذلك. أما النموذج الجديد فيركز على فهم الوسائط وإخراج النص.
التفكير واستدعاء الأدوات والبحث على الويب
يدعم النموذج مستويات متعددة من جهد التفكير، ويكون التفكير مفعّلًا افتراضيًا. يستطيع المطور الاختيار بين مستويات مثل low وmedium وxhigh، أو تعطيل التفكير إذا كانت المهمة لا تحتاج إلى استدلال عميق.
كذلك يدعم Function Calling، ما يسمح بربط النموذج بخدمات أو أدوات خارجية، إضافة إلى البحث على الويب عبر أداة مدمجة في Responses API. ومع دعم Chat Completions وResponses، يصبح دمجه أقرب إلى الأدوات التي اعتاد المطورون استخدامها مع واجهات OpenAI المتوافقة.
أين يتوفر النموذج؟
بحسب Alibaba Cloud Model Studio، يتوفر النموذج في مناطق تشمل بكين وسنغافورة وهونغ كونغ وطوكيو وفرانكفورت وفرجينيا، مع اختلاف نطاق الخدمة والأسعار حسب المنطقة. ويحتاج المطور إلى استخدام مفتاح API تابع للمنطقة التي يختارها.
ويأتي الإطلاق في وقت تشتد فيه المنافسة على نموذج Flash الذي يقدم أداءً مرتفعًا بسعر منخفض. وسبق أن تناولنا على سوالف إطلاق DeepSeek V4.1 Flash، وهو مثال آخر على تركيز الشركات الصينية على خفض تكلفة التشغيل مع الحفاظ على سياق كبير وقدرات متقدمة.
ما الذي يعنيه هذا للمطورين؟
بالنسبة للمطور الذي يبني خدمة تلخيص اجتماعات أو تحليل فيديو أو استخراج معلومات من تسجيلات طويلة، فإن النموذج الجديد يجمع ثلاثة عناصر مهمة: سياق ضخم، دعم أصلي للصوت والفيديو، وتسعير منخفض نسبيًا.
- يمكن إرسال نص مع صورة أو صوت أو فيديو وتحليل المحتوى داخل نفس الطلب.
- يمكن الاستفادة من مليون Token في المهام الطويلة بدل تقسيم المادة إلى أجزاء صغيرة جدًا.
- يمكن ربط النموذج بأدوات خارجية عبر Function Calling.
- يمكن استخدام البحث على الويب ضمن المهام التي تحتاج إلى معلومات حديثة.
- يوفر التخزين المؤقت للسياق وسيلة إضافية لتقليل التكلفة في السيناريوهات المتكررة.
لكن اختيار النموذج لا يجب أن يعتمد على السعر وحده. دقة التفريغ الصوتي، جودة فهم الفيديو، استهلاك Tokens الفعلي، زمن الاستجابة، وتوفر الخدمة في المنطقة المطلوبة كلها عوامل تحتاج إلى اختبار على بيانات المشروع نفسه.
في النهاية
يمثل Qwen3.8 Omni Flash توسعًا مهمًا في عائلة Qwen نحو نموذج واحد يتعامل مع النص والصورة والصوت والفيديو، مع سياق يصل إلى مليون Token، دعم 113 لغة ولهجة صوتية، صوت متعدد القنوات، التفكير، الأدوات والبحث على الويب.
الأبرز تجاريًا هو أن Alibaba تضع النموذج في مواجهة مباشرة مع Gemini 3.8 Flash في مهام فهم الصوت والفيديو، بينما تعرض أسعار API أقل بوضوح على مستوى المليون Token. ومع ذلك، فإن الادعاءات عن نسب خفض محددة في تكلفة الصوت يجب فصلها عن الأرقام الرسمية المنشورة؛ المقياس الحقيقي للمطور سيظل تكلفة المهمة الفعلية وجودة النتيجة على بياناته.
لا يسمح بنقل هذا المحتوى من سوالف دون الاشارة برابط مباشر