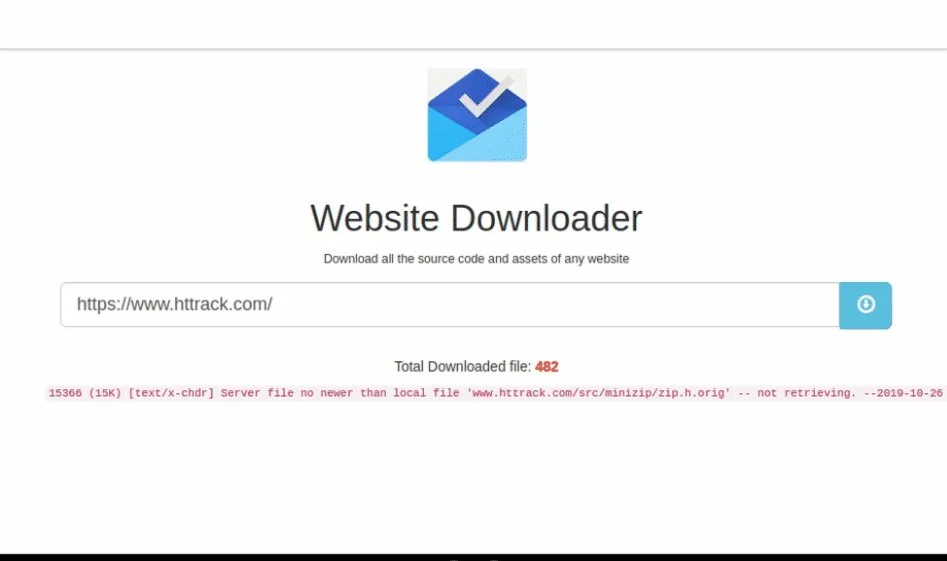
إذا احتجت يومًا إلى الاحتفاظ بنسخة كاملة من موقع ويب للعمل عليها محليًا، أو أرشفة صفحة بكل ملفاتها، أو فحص بنية موقع بعيدًا عن الاتصال بالإنترنت، فإن مشروع Website Downloader يقدم طريقة مباشرة لهذا الغرض عبر GitHub. المشروع مفتوح المصدر ومبني على Node.js، ويعتمد في عملية التنزيل على wget ثم يستخدم archiver لضغط الملفات وإعادتها إلى المستخدم كحزمة واحدة.
الإجابة السريعة
Website Downloader أداة مفتوحة المصدر لتنزيل موقع ويب كامل مع ملفاته الأساسية مثل HTML وCSS وJavaScript والصور، ثم ضغط الناتج في ملف يمكن حفظه وتشغيله محليًا. المشروع يعمل عبر Node.js ويستدعي wget لتنفيذ التنزيل المتكرر وتحويل الروابط لتناسب التصفح دون اتصال، وهو مناسب للأرشفة والاختبار والتعليم أكثر من كونه وسيلة لنسخ مواقع ديناميكية كما هي بكل وظائف الخادم.
كيف يعمل Website Downloader فعليًا؟
فكرة المشروع بسيطة من الخارج: تدخل عنوان موقع، ثم تبدأ عملية التنزيل، وبعد انتهائها تحصل على نسخة مضغوطة. لكن ما يحدث في الخلفية أهم قليلًا. وفق ملف README الرسمي، يستدعي التطبيق أمر wget بمجموعة من الخيارات المصممة لجعل النسخة الناتجة قابلة للتصفح محليًا، ثم يتولى archiver تجميع الملفات وإرسالها مرة أخرى إلى المستخدم عبر قناة Socket.
الأمر الأساسي الذي يعتمد عليه المشروع يستخدم خيارات مثل --mirror للتنزيل المتكرر، و--convert-links لتحويل الروابط إلى مسارات نسبية مناسبة للتصفح المحلي، و--adjust-extension لإضافة الامتدادات المناسبة للملفات، و--page-requisites لجلب الملفات الضرورية لعرض الصفحة مثل الصور وملفات CSS، وأخيرًا --no-parent لمنع التوسع إلى مستوى أعلى من المسار المطلوب.
هذه التفاصيل مهمة لأنها توضح أن الأداة لا تكتفي بحفظ ملف HTML واحد. الهدف هو إنشاء نسخة محلية أقرب إلى بنية الموقع التي يمكن تصفحها دون اتصال، مع جمع الأصول التي تحتاج إليها الصفحات للعرض بصورة سليمة قدر الإمكان.
ما الذي ينزله Website Downloader وما حدوده؟
المشروع يذكر صراحة أنه مصمم لتنزيل الكود المصدري والملفات المرتبطة بالموقع، بما في ذلك JavaScript وStylesheets والصور. لذلك يمكن أن يكون مفيدًا جدًا مع المواقع الثابتة، صفحات الهبوط، الوثائق العامة، أو الصفحات التي تعتمد بشكل كبير على ملفات يتم إرسالها مباشرة إلى المتصفح.
لكن من المهم التمييز بين «تنزيل ملفات الموقع» و«نسخ الموقع كاملًا بكل وظائفه». إذا كان الموقع يعتمد على PHP أو Node.js في الخادم، أو قواعد بيانات، أو تسجيل دخول، أو API خاصة، أو محتوى يتم توليده بعد المصادقة، فلن تحصل من هذه الأداة على منطق الخادم أو قاعدة البيانات لمجرد تنزيل الواجهة العامة. ما يمكن حفظه هو ما يستطيع wget الوصول إليه من الجهة العامة.
| ما يمكن الحصول عليه غالبًا | ما لا تحصل عليه تلقائيًا |
|---|---|
| HTML والصفحات العامة | كود الخادم الخاص |
| CSS وJavaScript المتاحان للمتصفح | قواعد البيانات |
| الصور والملفات المرتبطة | لوحات الإدارة المحمية |
| روابط محولة للتصفح المحلي | واجهات API الخاصة أو الأسرار |
| نسخة مناسبة للأرشفة أو المراجعة | تطبيق ديناميكي مطابق 100% للخادم الأصلي |
تشغيل Website Downloader محليًا
متطلبات التشغيل واضحة نسبيًا. يحتاج المشروع إلى Node.js 16 أو أحدث، إضافة إلى wget مثبتًا ومتاحًا في PATH. ويقدم README أوامر مختلفة لتثبيت wget على Debian وUbuntu وmacOS وWindows، ثم يمكن استنساخ المستودع وتثبيت الحزم وتشغيل الخادم محليًا.
- استنساخ مستودع المشروع من GitHub.
- الدخول إلى مجلد
Website-downloader. - تشغيل
npm installلتثبيت الاعتماديات. - التأكد من أن wget يعمل من سطر الأوامر.
- تشغيل
npm start. - فتح
http://localhost:3000/في المتصفح.
هناك أيضًا إعدادات اختيارية يمكن تمريرها عبر متغيرات البيئة. المنفذ الافتراضي هو 3000، بينما يحدد DOWNLOAD_QUOTA سقف حجم التنزيل الافتراضي عند 100 ميجابايت، ويحدد DOWNLOAD_TIMEOUT_MS مدة قصوى افتراضية تبلغ 300000 مللي ثانية، أي خمس دقائق. وجود هذين الحدين مهم إذا قررت استضافة الأداة بدل تشغيلها على جهازك، لأن تنزيل مواقع كبيرة بلا قيود قد يستهلك مساحة التخزين أو يبقي العمليات مفتوحة فترة طويلة.
Website Downloader – المشروع عاد للنشاط في 2026
من النقاط اللافتة أن Website Downloader ليس مستودعًا مهجورًا تمامًا. صفحة GitHub تظهر نحو 5.8 آلاف نجمة و1.3 ألف Fork وقت الفحص، مع 100 Commit في السجل. كما ظهرت تحديثات خلال أغسطس 2026، وهو ما يميز المشروع عن كثير من أدوات التنزيل القديمة التي توقفت منذ سنوات.
أحد التحديثات الحديثة عالج مشكلة عملية كانت تجعل بعض عمليات التنزيل تُبلغ المستخدم بالنجاح رغم عدم إنشاء أرشيف فعلي. كما أضافت التعديلات توثيقًا أوضح لمتطلب wget، وإعدادات للحصة والمهلة الزمنية، ومجلدات عمل منفصلة للتنزيلات والأرشيفات. هذه تغييرات صغيرة في الشكل لكنها مهمة لمن يعتمد على الأداة فعليًا.
واجهة ويب بدل حفظ أوامر wget يدويًا
يمكن تنفيذ معظم ما تفعله الأداة مباشرة من الطرفية باستخدام wget، لذلك السؤال الطبيعي هو: لماذا نحتاج Website Downloader أصلًا؟ الإجابة أن المشروع يحول سلسلة أوامر وإدارة ملفات إلى واجهة ويب أبسط. المستخدم لا يحتاج إلى حفظ الخيارات أو بناء الأوامر يدويًا في كل مرة، ويحصل في النهاية على ملف مضغوط جاهز.
هذا يجعل المشروع مناسبًا أيضًا كقاعدة يمكن لمطور أن يبني فوقها أداة داخلية، مثل خدمة أرشفة لمجموعة مواقع، أو واجهة تستخدم في الاختبار، أو تطبيق محلي لمستخدمين لا يريدون التعامل مع الطرفية. المستودع نفسه يتيح النشر على خدمات سحابية، لكن التشغيل المحلي يظل خيارًا منطقيًا عندما تكون الخصوصية أو استهلاك الموارد عاملًا مهمًا.
متى يكون Website Downloader مفيدًا فعلًا؟
أفضل سيناريوهات الاستخدام ليست محاولة «استنساخ الإنترنت»، بل مهام محددة يمكن التحكم فيها. من أمثلتها الاحتفاظ بنسخة من صفحة قبل إعادة تصميمها، أرشفة وثائق عامة، مراجعة الأصول المستخدمة في موقع، اختبار طريقة عمل الروابط المحلية، أو دراسة بنية مشروع ويب متاح للعامة لأغراض تعليمية.
- أرشفة نسخة محلية من موقع ثابت أو قسم محدد.
- الاحتفاظ بصفحات مرجعية للعمل دون اتصال.
- مراجعة ملفات CSS وJavaScript والصور العامة.
- اختبار تغييرات محلية على نسخة من صفحات تملكها أو لديك تصريح باستخدامها.
- تعلم كيفية عمل wget والتعامل مع التنزيل المتكرر والأرشفة في Node.js.
وبالطبع يجب احترام حقوق النشر وشروط المواقع والسياسات المعمول بها. كون الصفحة متاحة للعامة لا يعني تلقائيًا أن لك الحق في إعادة نشر محتواها أو تصميمها أو علامتها التجارية. الأداة تقنية، وطريقة استخدامها هي التي تحدد ما إذا كان الاستخدام مشروعًا ومناسبًا.
قيود Website Downloader قبل الاعتماد عليه
المستودع ما زال يضم Issues مفتوحة، كما أن صفحة العرض الحي كانت قد تعرضت سابقًا لمشكلة توقف مسجلة في GitHub. لذلك لا ينبغي التعامل مع النسخة المستضافة كخدمة مضمونة دائمًا. من يريد استخدام الأداة بصورة جدية سيكون أفضل حالًا بتشغيلها محليًا أو على خادم يملكه ويتحكم في موارده.
كذلك، اعتماد المشروع على wget يعني أن نجاح التنزيل يرتبط بطبيعة الموقع المستهدف. المواقع التي تعتمد بقوة على JavaScript لتوليد الصفحة بعد التحميل، أو تحتاج إلى جلسات تسجيل دخول معقدة، أو تطبق حماية ضد الزحف، قد لا تنتج نسخة محلية مكتملة بالطريقة التي تتوقعها. في هذه الحالات قد تحتاج أدوات تعتمد على متصفح فعلي مثل Playwright أو Puppeteer بدل التنزيل التقليدي.
مشروع صغير بفكرة واضحة ويمكن البناء فوقه
قيمة Website Downloader ليست في أنه يقدم تقنية غير مسبوقة، فـwget موجود منذ سنوات طويلة، بل في جمع عملية التنزيل والأرشفة داخل تطبيق ويب مفتوح المصدر وسهل الفهم نسبيًا. الترخيص MIT يسمح بدراسة الكود وتعديله وإعادة استخدامه ضمن شروط الترخيص، وهذا يجعله مناسبًا للمطور الذي يريد نقطة بداية بدل بناء كل شيء من الصفر.
كما أن بنية المستودع نفسها مفيدة للتعلم: هناك فصل لمجلدات routes وsocket وviews وwget وarchiver، ويمكن تتبع تدفق العملية من استقبال الرابط حتى إنشاء الأرشيف وإرساله. ولهذا قد يكون المشروع مفيدًا حتى لمن لا يحتاج تنزيل موقع كامل، لكنه يريد مثالًا عمليًا لتنسيق عدة أدوات داخل تطبيق Node.js بسيط.
هل يستحق Website Downloader التجربة؟
إذا كان المطلوب نسخة محلية من موقع عام أو أداة بسيطة للأرشفة، فإن Website Downloader يقدم حلًا مباشرًا ومفتوح المصدر مع إعداد محلي سهل نسبيًا. أما إذا كنت تريد نسخ تطبيق ويب ديناميكي بكل قاعدة بياناته ومنطق الخادم وحساباته، فهذه ليست وظيفة المشروع أصلًا، وستحتاج إلى وصول حقيقي إلى الخادم أو نسخة احتياطية من النظام المصدر.
يمكن الوصول إلى مستودع Website Downloader الرسمي على GitHub لمراجعة الكود، خطوات التشغيل، آخر التحديثات والمشكلات المفتوحة قبل استخدامه.
لا يسمح بنقل هذا المحتوى من سوالف دون الاشارة برابط مباشر